
Lambda 13 অক্টোবর, 2026-এ বলেছিল যে এটি NVIDIA-এর সাথে ওপেন সোর্স Run:ai GPU শিডিউলারকে Lambda Kubernetes Service (LKS)-এ একটি প্রথম-শ্রেণির পরিচালিত বিকল্প হিসেবে কাজ করছে, যা পরিচালিত উপাদান হিসাবে বিতরণ করা শিডিউলারের একটি পরিকল্পিত লাইব্রেরির অংশ।
প্রোগ্রামটি 13 অক্টোবর, 2026-এ ল্যাম্বডা ব্লগে একটি পোস্টে উপস্থিত হয়েছিল। “আমরা NVIDIA-এর ওপেন সোর্স Run:ai-এর সিদ্ধান্তকে স্বাগত জানাই, এবং আমরা এটিকে Lambda Kubernetes Service (LKS)-এ একটি প্রথম-স্তরের বিকল্প হিসাবে তৈরি করার জন্য কাজ করছি,” কোম্পানি বলেছে৷ Lambda বলেছেন যে এটি 2022 সাল থেকে Run:ai-কে তার অবকাঠামোতে সমর্থন করেছে, এবং LKS-এর মাধ্যমে Run:ai-এর ক্ষমতাগুলিকে গ্রহণ করা এবং পরিচালনা করা সহজ করার লক্ষ্যে তার লক্ষ্য বর্ণনা করেছে যাতে দলগুলি কীভাবে GPU ক্ষমতা বরাদ্দ এবং ভাগ করা হয় তার উপর আরও নিয়ন্ত্রণ লাভ করে।
2025 সালে NVIDIA ওপেন সোর্স শিডিউলার
NVIDIA একটি NVIDIA ঘোষণা অনুসারে, এপ্রিল 1, 2025-এ Apache 2.0 লাইসেন্সের অধীনে Run:ai প্ল্যাটফর্মের মধ্যে তৈরি একটি নেটিভ কুবারনেটস GPU শিডিউলিং সলিউশন, KAI শিডিউলারের ওপেন সোর্স রিলিজ ঘোষণা করেছে। NVIDIA বলেছে যে সময়সূচীটি NVIDIA Run:ai প্ল্যাটফর্মের অংশ হিসাবে প্যাকেজ করা এবং বিতরণ করা অব্যাহত রয়েছে।
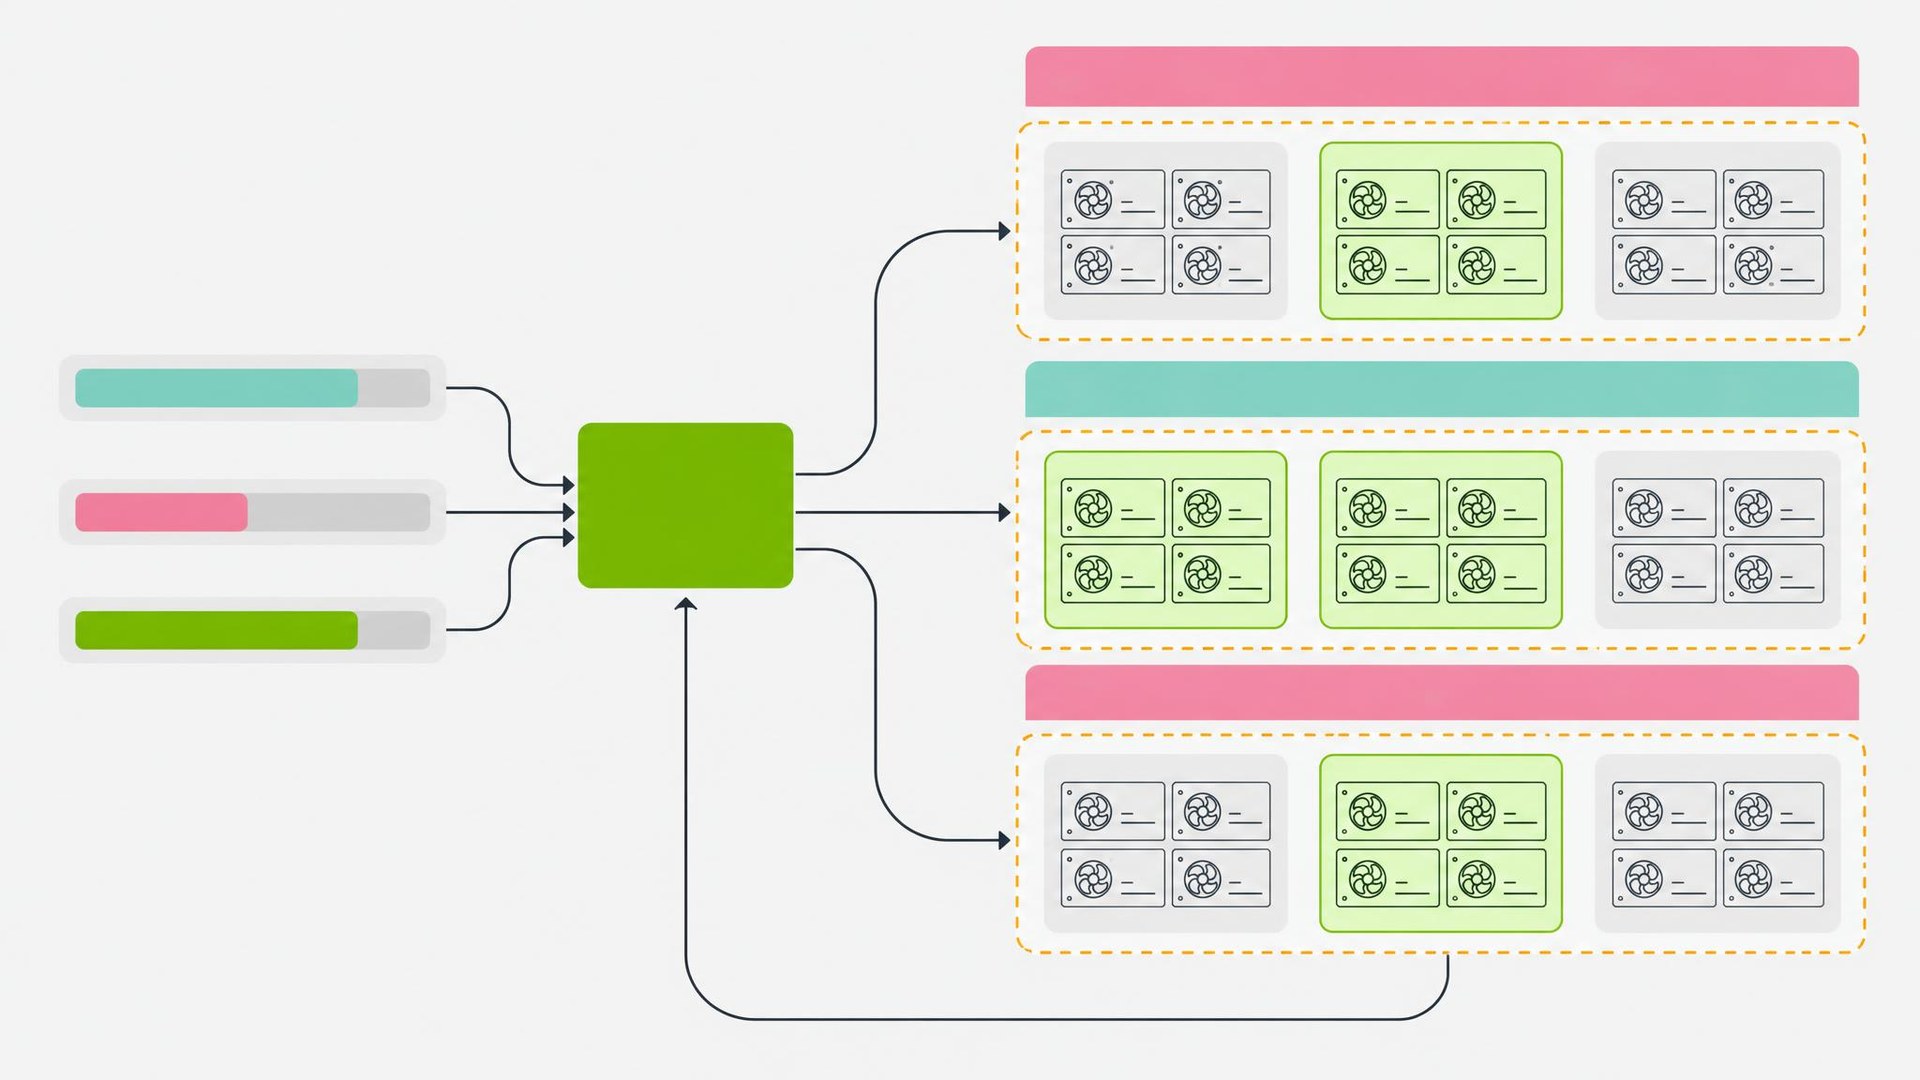
NVIDIA-এর মতে, শিডিউলকারী ক্রমাগত ন্যায্য শেয়ারের মান পুনঃগণনা করে এবং রিয়েল-টাইমে কোটা এবং সীমা সামঞ্জস্য করে, গ্যাং শিডিউলিং, GPU শেয়ারিং, এবং শ্রেণীবিন্যাস সারিগুলিকে একত্রিত করে, যখন একটি অন্তর্নির্মিত পডগ্রুপার স্বয়ংক্রিয়ভাবে কুবেফ্লো, রে, আর্গো এবং ট্রেন অপারেটার সহ ফ্রেমওয়ার্কের সাথে ওয়ার্কলোডগুলিকে সংযুক্ত করে। NVIDIA একটি সময়সূচী চক্রের বর্ণনা করে যা একটি Kubernetes ক্লাস্টারের একটি স্ন্যাপশট ক্যাপচার করে, প্রতিটি সারির জন্য ন্যায্য অংশের জন্য নির্ধারিত কোটা এবং ওভারকোট পর্যায়গুলির মাধ্যমে গণনা করে এবং তারপরে গণনা করা অবস্থায় বর্তমান বরাদ্দের সাথে মেলানোর জন্য বরাদ্দ, একত্রীকরণ, পুনরুদ্ধার এবং প্রিম্পশন অপারেশন প্রয়োগ করে৷
Run:ai-তে GPU শেয়ারিং এবং কোটা সময়সূচী
Lambda বিভিন্ন চাহিদা বর্ণনা করেছেন যেগুলি AI ডেভেলপমেন্ট জিপিইউগুলিতে স্থান করে: ডিবাগিং সেশনগুলির শুধুমাত্র একটি একক GPU-এর অংশের প্রয়োজন হতে পারে, মূল্যায়নগুলি অনেকগুলি স্বাধীন চাকরিতে বিকশিত হতে পারে, এবং বিতরণ করা প্রশিক্ষণের জন্য একযোগে প্রচুর সংখ্যক শক্তভাবে সংযুক্ত GPU-এর প্রয়োজন হতে পারে, যেহেতু কাজ প্রাথমিক ধারণাগুলি থেকে ট্রায়ালের মাধ্যমে উত্পাদনের দিকে অগ্রসর হয়৷ যখন ছোট কাজগুলি সম্পূর্ণ GPU গুলি পায়, তখন গবেষকরা সংরক্ষিত ক্ষমতা অব্যবহৃত হওয়ার জন্য অপেক্ষা করেন এবং দলগুলি তাদের পরীক্ষাগুলি অন্য গ্রুপের সংরক্ষিত কিন্তু নিষ্ক্রিয় GPU গুলির পিছনে আটকে থাকতে পারে৷
Run:ai, যেমন Lambda বর্ণনা করেছেন, Kubernetes-এর জন্য একটি GPU সময়সূচী যা ডিফল্ট Kubernetes সময়সূচী থেকে দুটি উপায়ে বিচ্যুত হয়: GPU শেয়ারিং, যা একটি একক GPU-তে একাধিক কাজের চাপ চালানোর অনুমতি দেয়, এবং কোটা-ভিত্তিক সময়সূচী, যা প্রতিটি দলকে একটি গ্যারান্টিযুক্ত বরাদ্দ দেয় যখন প্রতিটি দলকে অন্যদের কাছ থেকে ধার নেওয়ার ক্ষমতা দেয়।
NVIDIA-এর GPU শার্ডিং ডকুমেন্টেশনে বলা হয়েছে যে শার্ডগুলি GPU মেমরিকে ছোট ছোট খণ্ডে ভাগ করে যা একাধিক ওয়ার্কলোড ভাগ করতে পারে, প্রতিটি কাজের চাপের অনুরোধকৃত মেমরির আকার প্রয়োগ করা হয় যাতে এটি তার অনুরোধকে অতিক্রম করতে না পারে বা অন্য কাজের চাপের মেমরিকে সীমাবদ্ধ করতে না পারে। প্রতিটি পড তার নিজস্ব ভার্চুয়াল মেমরি ঠিকানা স্থান পায়, একটি বিন্যাস ডকুমেন্টেশন কল “লজিক্যাল GPU”।
ডকুমেন্টেশন অনুসারে শার্ডগুলি ডিফল্টভাবে GPU কম্পিউটিং ভাগ করার জন্য NVIDIA টাইম স্লাইসিং ব্যবহার করে, এবং মাল্টি-GPU শার্ডগুলি একটি একক নোডের মধ্যে একাধিক GPU গুলিতে একই শার্ড আকার বরাদ্দ করে: একটি মডেল যা 8 GPU ব্যবহার করে এবং প্রতি GPU 40GB মেমরি প্রয়োজন, উদাহরণস্বরূপ, প্রতিটি উপলব্ধ GPU মেমরির 8x40GB মেমরির পরিবর্তে 8x40GB বরাদ্দ করা হতে পারে৷ এই নোডে কাজের চাপ। ডকুমেন্টেশনে বলা হয়েছে যে GPU টুকরা এবং মাল্টি-ইনস্ট্যান্স GPU (MIG) মোড একই নোডে ব্যবহার করা যাবে না।
এনভিআইডিআইএ শিডিউলারের ধারণার ডকুমেন্টেশনে বলা হয়েছে যে প্রতিটি নতুন তৈরি করা পড পডের একটি গোষ্ঠীতে বরাদ্দ করা হয় এবং সেই গ্যাং শিডিউলিংয়ের অর্থ হল একাধিক পড সমন্বিত একটি কাজের চাপ হয় সম্পূর্ণরূপে নির্ধারিত বা হোল্ডে রয়েছে। প্রতিটি নোড পুলের জন্য প্রতিটি প্রকল্প এবং বিভাগের জন্য একটি সময়সূচী সারি তৈরি করা হয়; সঠিক কোটা সীমিত করে যে অ-বাতিলযোগ্য ওয়ার্কলোডগুলি চলতে পারে, যখন অতিরিক্ত কোটা সংস্থানগুলি শুধুমাত্র বাতিলযোগ্য কাজের চাপের জন্য উপলব্ধ। শিডিউলার প্রতিটি প্রোজেক্ট এবং ক্লাস প্রতি নোড পুলের জন্য একটি ন্যায্য শেয়ারের মান গণনা করে, এবং যখন একটি সারি তার ন্যায্য শেয়ারের নীচে বসে যখন অন্য একটি সারি এটি ছাড়িয়ে যায়, তখন শিডিয়ুলার পুনরায় ভারসাম্যের জন্য সারির মধ্যে সংস্থান স্থানান্তর করে, একটি প্রক্রিয়া যা অতিরিক্ত বরাদ্দকরণ রোধ করতে পারে। এটি প্রকল্প এবং বিভাগগুলির মধ্যে সংস্থানগুলিও ফেরত দিতে পারে এবং প্রশাসকরা প্রতিটি নোড পুলের জন্য বিন-প্যাক বা প্লেসমেন্ট কৌশলগুলি সংজ্ঞায়িত করতে পারে।
LKS-এ একটি নোডের স্বয়ংক্রিয় মেরামত
Lambda উল্লেখ করেছেন যে শেয়ারিং এবং অনুমান উভয়ই অনুমান করে যে অন্তর্নিহিত GPU স্বাস্থ্যকর, এবং স্কেলে এটি সুস্পষ্ট নয়: এক্সিলারেটরগুলি XID ত্রুটি ফেলে দেয়, NVLink এবং PCIe লিঙ্কগুলি শেষ হয়ে যায়, মেমরি লাইনগুলি পুনরায় তৈরি হয় এবং InfiniBand পোর্টগুলি তাদের প্রত্যাশিত হারের নীচে নেমে যায়। একটি সময়সূচী একটি সুস্থ GPU এবং একটি ব্যর্থ একটির মধ্যে পার্থক্য করতে পারে না, তাই এটি নোডে কাজ পাঠাতে থাকে যা তাদের ড্রপ করে।
ল্যাম্বদাকে জানানো হয়েছিল যে ইতিমধ্যেই এলকেএস-এ একটি স্বয়ংক্রিয় সংশোধন পাঠানো হয়েছে। কোম্পানি বলেছে যে এটি এই ধরনের ব্যর্থতার জন্য প্রতিটি নোড নিরীক্ষণ করে এবং প্রতিটিকে একটি স্ট্যান্ডার্ড কুবারনেটস নোড স্টেট হিসাবে প্রকাশ করে; যখন একটি স্টেট চালু থাকে, তখন নোডটি নতুন কাজের জন্য নোঙর করা হয়, চলমান কাজগুলি খালি করা হয় এবং ত্রুটিটি স্বয়ংক্রিয়ভাবে মেরামত করা হয় বা হার্ডওয়্যার মেরামতের জন্য বাড়ানো হয়, নোডটি পুনরায় যাচাই করার পরেই পরিষেবাতে ফিরে আসে।
Lambda পরিচালিত Kubernetes ডকুমেন্টেশন পরিষেবাটিকে GPU এবং InfiniBand (RDMA) সমর্থন সহ একটি Kubernetes পরিবেশ হিসাবে বর্ণনা করে এবং একটি 1-ক্লিক ক্লাস্টারে সমস্ত নোড জুড়ে অবিরাম স্টোরেজ শেয়ার করে। NVIDIA GPU অপারেটর এবং NVIDIA নেটওয়ার্ক অপারেটর আগে থেকে ইনস্টল করা আছে, এবং হার্ডওয়্যার সমস্যা সনাক্ত করতে এবং পুনরুদ্ধার করতে স্বয়ংক্রিয় নোড মেরামতের পাশাপাশি GPU, নেটওয়ার্ক এবং স্টোরেজ সঠিকভাবে কাজ করছে তা নিশ্চিত করতে পরিষেবাটি ক্রমাগত যাচাইকরণ চালায়।
পরিচালিত শিডিউলার লাইব্রেরির রোডম্যাপ
Lambda GPU শিডিউলিংকে একটি স্তর হিসাবে বর্ণনা করেছে যা এটি ইচ্ছাকৃতভাবে খোলা থাকে, LKS বলে যে এটিকে একটি কৃত্রিম বুদ্ধিমত্তা সফ্টওয়্যার লাইব্রেরি বলা হয়: Kubernetes, Slurm এবং Run:ai-এ চলমান সময়সূচী, তাদের মধ্যে পরিচালিত উপাদান হিসাবে পাঠানো হয় যা Lambda তার নিজস্ব হার্ডওয়্যারের বিরুদ্ধে যাচাই করে এবং সেগুলিকে গ্রাহকদের থেকে আপ-টু-ডেট করে রাখে। Run:ai এই লাইব্রেরির জন্য একটি প্রধান লক্ষ্য, এবং Lambda বলেছেন যে এটি সেখানে যাওয়ার জন্য NVIDIA-এর সাথে কাজ করছে।
Lambda এর মতে, এটি ওপেন সোর্স সংস্করণ যা এই পদ্ধতিকে সক্ষম করে: কোম্পানিটি গ্রাহকদের একীকরণ নির্দেশাবলীর একটি সেট হস্তান্তর করার পরিবর্তে LKS-এর মধ্যে Run:ai প্যাকেজ, পরীক্ষা এবং বজায় রাখতে পারে। ল্যাম্বদা বলেছেন যে এটির লক্ষ্য হল আউট-অফ-দ্য-বক্স একীকরণ যেখানে এটি প্যাকেজিং, প্রমাণীকরণ এবং চলমান ক্রিয়াকলাপগুলির মালিক।
ল্যাম্বদা, যা তার নিজস্ব ওপেন-সোর্স গবেষণা তৈরি করে, বলেছে যে এটি যে সরঞ্জামগুলির উপর নির্ভর করে তা পরীক্ষা, মানিয়ে নেওয়া এবং উন্নত করার ক্ষমতাকে মূল্য দেয় এবং এনভিআইডিআইএর সিদ্ধান্তকে অর্কেস্ট্রেশনের স্বাধীনতাকে প্রসারিত হিসাবে বর্ণনা করে।




Leave a Reply